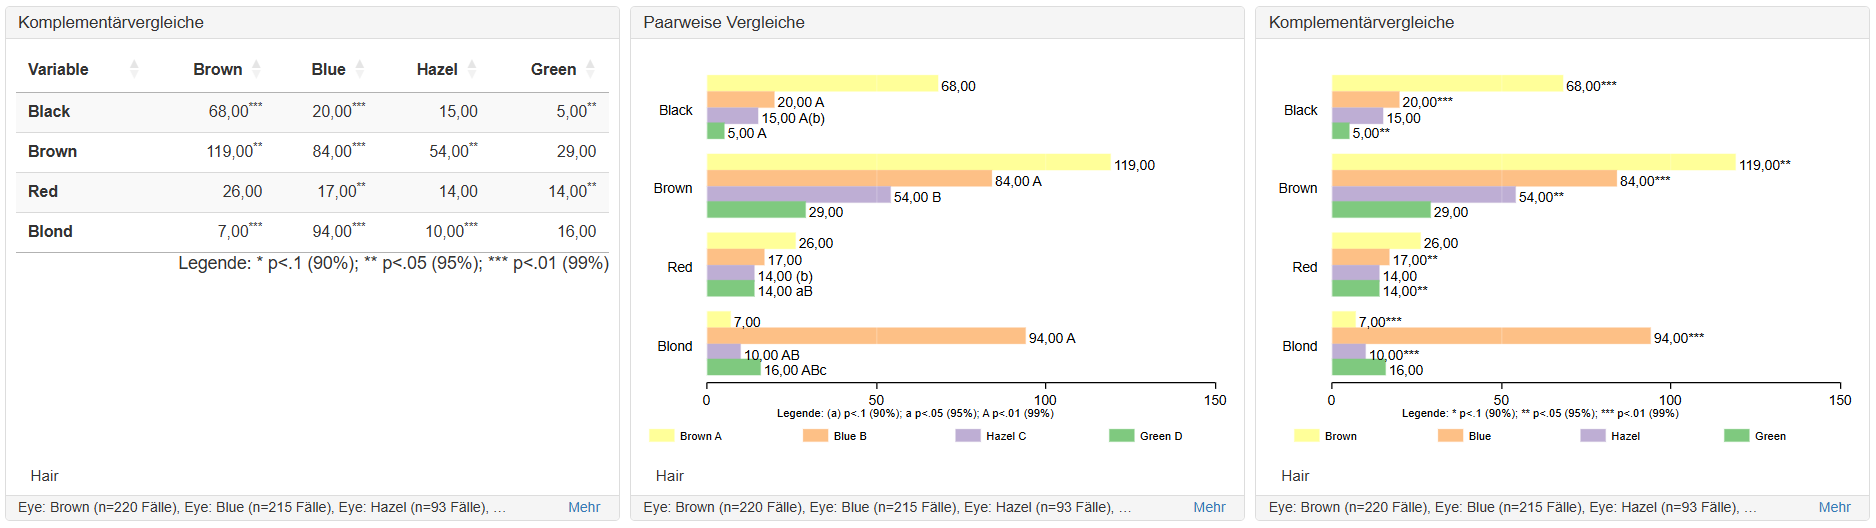
Signifikanzen (Gruppenvergleiche) in Tabellen und Balken-/Säulendiagrammen anzeigen
Es ist möglich, Signifikanzen in Tabelle, Säulen-, und Balkendiagrammen anzeigen zu lassen.
Wählen Sie bei einem Chart unter den Einstellungen → Signifikanzen den gewünschten Test aus.
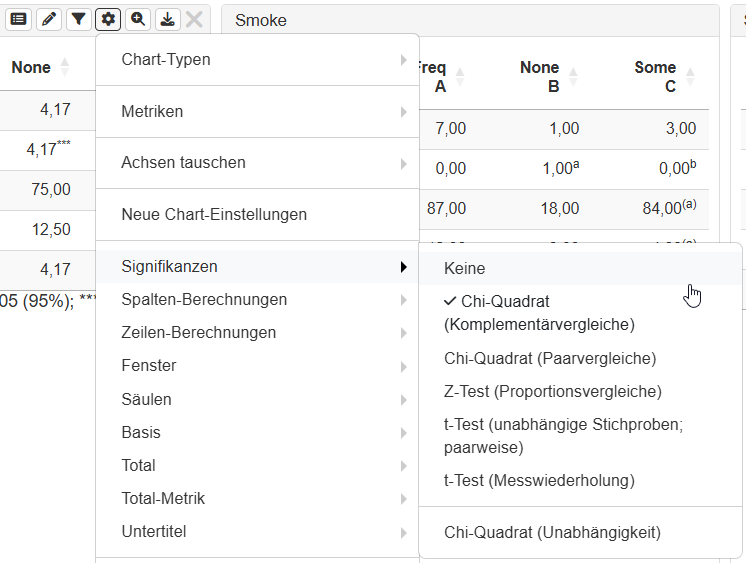
Folgende Tests stehen derzeit zur Verfügung
-
Chi-Quadrat (Komplementärvergleiche):
Vergleicht erwartete vs. beobachtete Häufigkeiten zwischen jeder einzelnen Zelle und deren Komplement (alle anderen Ausprägungen). -
Chi-Quadrat (Paarvergleiche):
Vergleicht paarweise erwartete vs. beobachtete Häufigkeiten zwischen Zellen. -
Z-Test (Proportionsvergleiche):
Vergleicht paarweise die Prozentsätze zwischen Zellen auf Signifikanz -
t-Test (unabhängige Stichproben; paarweise):
Vergleicht paarweise Mittelwerte zwischen jeweils zwei unabhängigen Gruppen (z.B. Geschlecht) in Bezug auf eine abhängige Variable. -
t-Test (Messwiederholung):
Vergleicht paarweise Mittelwerte zwischen zwei Messzeitpunkten (oder Bedingungen) derselben Personen in Bezug auf eine abhängige Variable. -
Chi-Quadrat (Unabhängigkeit)
Testet zwei Variablen auf statistische Unabhängigkeit. -
In Arbeit: t-Test (abhängige Stichproben)
Vergleicht paarweise Mittelwerte zwischen zwei Ratings (z.B. Produkte) derselben Personen in Bezug auf eine abhängige Variable.
Empfohlene Metriken
-
Chi-Quadrat Tests: Absolute Werte
-
Z-Test: Prozent
-
t-Test: Mittelwert
Hinweise:
-
Für die t-Tests muss die abhängige Variable als numerisch im Codebook angelegt sein!
-
Für die Chi-Quadrat Tests kann in den Charteinstellungen die Yates-Korrektur de-/aktiviert werden.
Korrektur für multiples Testen
Vergleichen Sie viele Spalten auf einmal, erscheinen manche Unterschiede allein durch Zufall signifikant. Ab Release 2026.3.200 korrigiert DataLion die p-Werte dafür. Öffnen Sie Chart-Stil → Anpassen → Signifikanzen und wählen Sie unter Korrektur für multiples Testen:
- Keine: Voreinstellung, ohne Korrektur.
- Bonferroni: die strengste Korrektur.
- Holm: schützt genauso vor Zufallstreffern wie Bonferroni, ist aber weniger streng und findet mehr Unterschiede.
- Benjamini-Hochberg (False Discovery Rate): begrenzt den Anteil falscher Treffer unter den signifikanten Ergebnissen.
DataLion korrigiert jede Tabellenzeile um die Zahl der Vergleiche in dieser Zeile. Die Legende nennt die Methode, zum Beispiel „Paarweise, je Zeile nach Holm korrigiert.“, am Bildschirm und in jedem Export. Für den Chi-Quadrat-Test auf Unabhängigkeit gibt es die Korrektur nicht.
Signifikanzen bei gewichteten Daten
Ab Release 2026.3.200 rechnen z-Tests und Chi-Quadrat-Tests auf gewichteten Anteilen mit der effektiven Fallzahl nach Kish als Basis. Sie ist kleiner, je ungleicher die Gewichte sind. Die Tests melden dadurch seltener Unterschiede, die nur wegen der Gewichtung signifikant wirken. Die Legende sagt dann „Gewichtet: getestet auf der effektiven Fallzahl (Kish).“, und Charts wie Tabellen nennen den Wert als n eff. neben der Basis. Mehr dazu unter Gewichtungen in DataLion.
Darstellung der Signifikanzen (Signifikanzniveaus können der Legende entnommen werden):
-
Komplementärvergleiche: es wird mit Sternchen dargestellt, ob sich eine Gruppe von den anderen unterscheidet. Die Anzahl an Sternchen repräsentiert das Signifikanzniveau.
-
Ein Buchstabe nach einem Wert gibt an, gegen welche Vergleichsgruppe der jeweilige Wert signifikant ist. Jede Vergleichsgruppe erhält einen Buchstaben (entweder in den Spalten oder den Labels für die Kategorien). Die Darstellung des Buchstaben repräsentiert das Signifikanzniveau.