
Kurz gesagt: Wer eine .sav-Datei öffnet, sieht, was darin steckt. Wer sie auswertet, will wissen, was die Daten aussagen, und dafür sind ein paar Entscheidungen nötig, die eine Häufigkeitstabelle nicht abnimmt. Vor dem ersten Prozentwert müssen Codes wie 99 für „keine Angabe“ ausgeschlossen und die Gewichtungsvariable gesetzt sein. Danach folgen Häufigkeiten mit Wertelabels, Kreuztabellen nach Untergruppen mit Signifikanztests und ein Weg, die Ergebnisse in Folien zu bringen. Dieser Leitfaden geht die Schritte an einer typischen Befragungsdatei durch und zeigt, wo jeder davon ohne SPSS-Lizenz stattfindet.
Direkt zu den Werkzeugen: Mit dem kostenlosen SPSS-Inspector sehen Sie in die Datei hinein (er läuft im Browser, nichts wird hochgeladen). Für die Auswertung importieren Sie die Datei in DataLion.
1. Prüfen, was in der Datei steckt
Eine .sav-Datei enthält mehr als Zahlen. Neben den Daten speichert sie die Variablenlabels („Wie zufrieden sind Sie mit …“), die Wertelabels (1 = „sehr unzufrieden“ bis 5 = „sehr zufrieden“), die Definition fehlender Werte und, falls die Studie eine hat, die Gewichtungsvariable. Die meisten Auswertungsfehler beginnen damit, dass eines davon übersehen wird.
Öffnen Sie die Datei im SPSS-Inspector und gehen Sie das Codebuch einmal durch. Vier Dinge lohnt es sich zu notieren:
- Codes für „weiß nicht“ und „keine Angabe“: oft 9, 98 oder 99. Wenn die Datei sie nicht als fehlend ausweist, landen sie in jedem Mittelwert.
- Die Gewichtungsvariable: Wenn die Datei eine nennt, erwartet das Institut oder Panel, das sie geliefert hat, dass Sie sie verwenden.
- Mehrfachantworten: meist als eine 0/1-Variable je Antwortoption gespeichert, etwa q5_1 bis q5_8.
- Offene Antworten: Textvariablen mit Wortlauten, die erst codiert werden müssen, bevor man sie zählen kann.
Der Inspector liest die Datei lokal und zeigt für jede Variable eine Häufigkeitstabelle mit Wertelabels. Damit verstehen Sie die Datei. Für die Auswertung selbst braucht es ein Programm, das Variablen kreuzt und Unterschiede testet.
2. Fehlende Werte und Gewichtung vor dem ersten Prozentwert festlegen
Zwei Einstellungen entscheiden darüber, ob jede Zahl danach stimmt. Die erste sind fehlende Werte. Auf einer Fünferskala zieht ein „weiß nicht“ mit dem Code 9 den Mittelwert nach oben, ein „keine Angabe“ mit 99 noch viel weiter. Schließen Sie diese Codes je Frage aus und prüfen Sie danach die Basis (n) jeder Frage: Fragen hinter einem Filter haben bewusst kleinere Basen, und eine Basis, die plötzlich größer ist als erwartet, deutet meist auf einen durchgerutschten Fehlcode hin.
Die zweite ist die Gewichtung. Stichproben treffen die Grundgesamtheit selten genau nach Alter, Geschlecht oder Region, deshalb liefern Institute und Panels eine Gewichtungsvariable, die das ausgleicht. Berichten Sie gewichtete Anteile und Mittelwerte und zeigen Sie die ungewichtete Fallzahl daneben, damit Leser sehen, auf wie vielen Antworten eine Zahl beruht.
In DataLion kommt beides mit der Datei. Der SPSS-Import übernimmt die Definitionen fehlender Werte und die Gewichtungsvariable aus der .sav. Codes, die die Datei nicht als fehlend ausweist, schließen Sie je Frage im Codebook aus (fehlende Werte), und eine Datei ohne Gewicht lässt sich auf Zielverteilungen gewichten (Gewichtung).
3. Häufigkeiten mit Labels lesen
Der erste Durchgang ist eine Häufigkeitstabelle je Frage, mit Labels statt Codes. Bei Skalenfragen tragen zwei Kennzahlen den größten Teil der Aussage: die Top-2-Box, also der Anteil der beiden besten Antworten, und der Mittelwert. Die Top-2-Box lässt sich im Meeting leichter erklären, der Mittelwert reagiert auf die ganze Verteilung. Berichten Sie beides für die Fragen, um die es in der Studie geht, und entscheiden Sie sich beim Rest für eine Kennzahl.
DataLion baut das Codebook aus den Labels der Datei und berechnet für jede Skalenfrage die Top- und Bottom-Boxen automatisch. Eine Tabelle auf die Top-2-Box umzustellen ist deshalb ein Klick.
4. Nach Untergruppen kreuzen und Unterschiede testen
Häufigkeiten beschreiben die ganze Stichprobe. Die meisten Fragen, die ein Bericht beantworten muss, sind aber Vergleiche: Bewerten jüngere Kunden den Service schlechter, fällt eine Region zurück, hat sich die Zufriedenheit seit der letzten Welle verändert? Das ist eine Kreuztabelle, mit der Frage in den Zeilen, der Untergruppe in den Spalten und Spaltenprozenten in den Zellen.
Jede Kreuztabelle zeigt Unterschiede, und viele davon sind Rauschen. Ein Signifikanztest trennt beides. Bei Anteilen vergleicht ein Chi²- oder z-Test jede Spalte mit den anderen, bei Mittelwerten ein t-Test. Markieren Sie Unterschiede auf dem 95-Prozent-Niveau und lesen Sie Spalten mit weniger als etwa 30 Fällen vorsichtig, denn dort verschiebt eine einzige Antwort den Wert um mehrere Punkte.
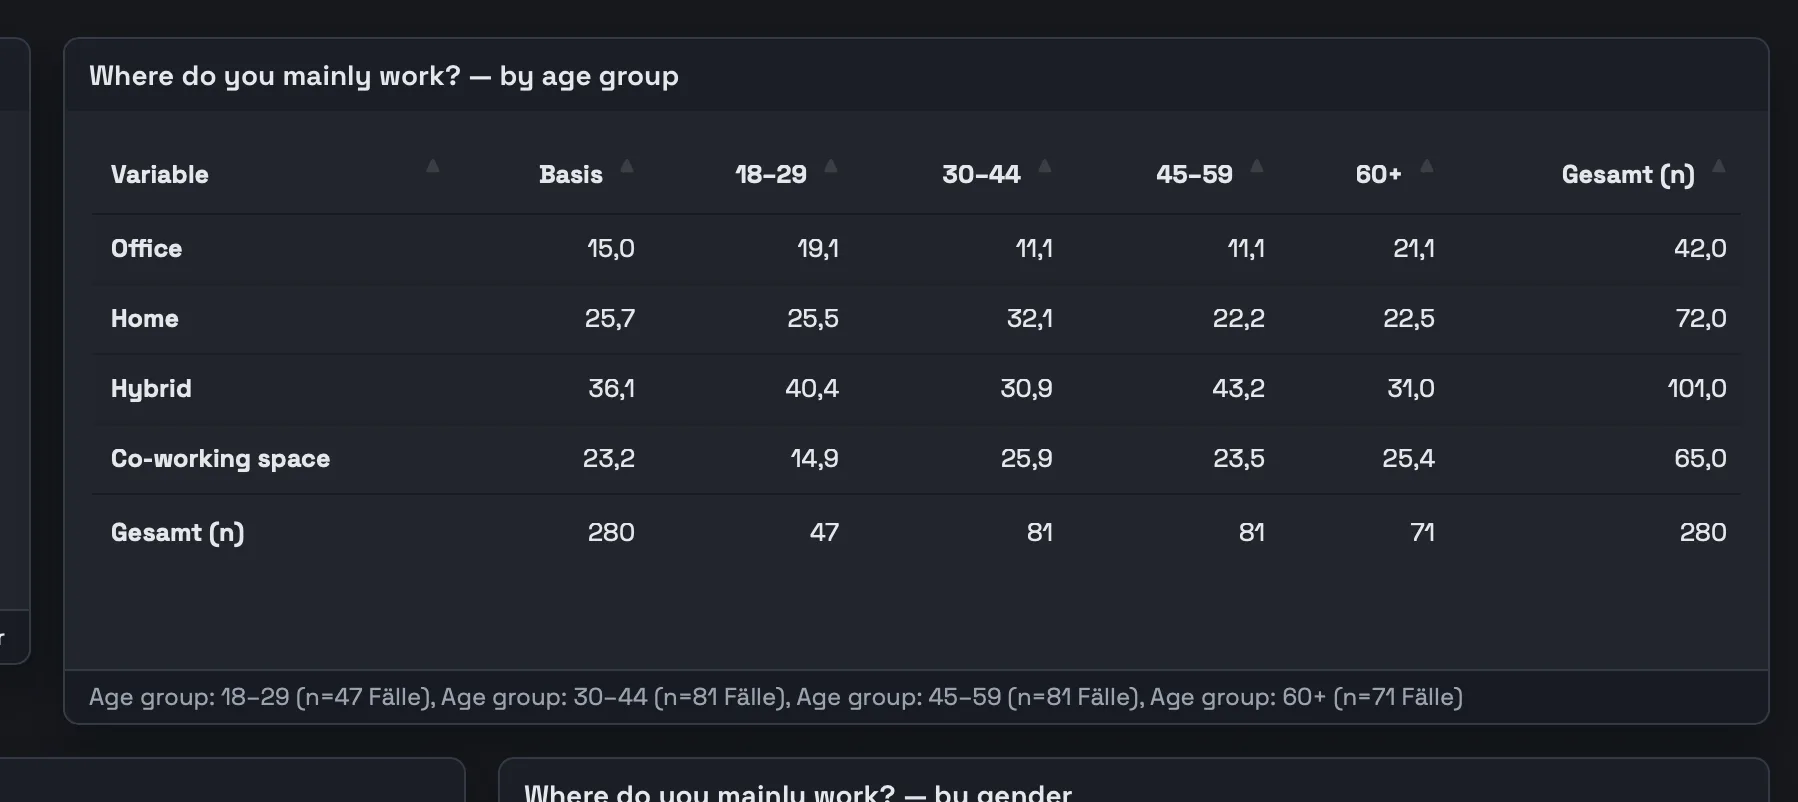
In DataLion lassen sich Aufrisse verschachteln, etwa Alter innerhalb der Region, und das Testergebnis steht direkt in der Tabelle, auf 80, 90, 95 oder 99 Prozent, als Sterne oder Buchstaben (Kreuztabellen, Signifikanztests).
5. Mehrfachantworten und offene Antworten
Eine Mehrfachantwortfrage kommt als Satz von 0/1-Variablen an. Einzeln berichtet ergibt sie acht Tabellen für eine Frage, gebündelt eine Tabelle mit dem Anteil der Befragten je Option. Im Codebook von DataLion bündeln Sie solche Variablen per Platzhalter (q5_*) zu einer Frage, und die Bündelung wird bei jeder neuen Welle wieder angewendet.
Offene Antworten überspringen die meisten Auswertungen, weil das Codieren von Hand Tage dauert. Die Textanalyse in DataLion ordnet jede Antwort nach Stimmung und Thema ein und schreibt das Ergebnis als neue Variablen zurück. Danach lassen sie sich kreuzen und testen wie jede geschlossene Frage.
6. Die Ergebnisse herausbringen
Eine Auswertung endet meist in einem Foliensatz, und beim Kopieren einzelner Tabellen nach PowerPoint gehen Formatierungen kaputt und Zahlen veralten. DataLion exportiert Charts, Tabellen und ganze Dashboards als bearbeitbare PowerPoint-Folien in Ihrer eigenen Vorlage (PowerPoint-Export), und Dashboards lassen sich teilen, auch mit Personen ohne Konto. Wer im Team weiter mit SPSS arbeitet, bekommt die aufbereiteten Daten als beschriftete .sav-Datei zurück.
Welcher Weg passt
Ohne SPSS-Lizenz gibt es drei Wege, eine .sav-Datei auszuwerten. PSPP ist ein kostenloses Desktop-Programm für Auswertungen im SPSS-Stil, Syntax inklusive. R liest mit dem Paket haven .sav-Dateien und kann alles, was sich programmieren lässt. Beide lassen die Daten auf Ihrem Rechner, und beide erwarten, dass Sie wie ein Statistiker arbeiten.
DataLion läuft im Browser. Sie laden die Datei auf Server in Deutschland hoch, die Schritte oben erledigen Sie über Menüs, und die Ergebnisse sind sofort teilbar. Wenn ein Projekt mehr als Tabellen braucht, gehören Regression und Treiberanalyse zum selben Werkzeug. In den ersten 14 Tagen ist jede Funktion enthalten, genug, um eine Studie von der Datei bis zum Foliensatz durchzuziehen.
Nächster Schritt
Öffnen Sie Ihre Datei im SPSS-Inspector und notieren Sie die Fehlcodes und die Gewichtungsvariable. Dann importieren Sie sie in DataLion und bauen die Kreuztabelle für die Frage, die Ihr Bericht beantworten muss. Wie eine Befragung über die SPSS-Datei hinaus ausgewertet wird, von der Bereinigung bis zum Bericht, beschreibt der Leitfaden Umfrage auswerten.